Works
Notes "Full Stack Challenge de Ensolvers"
01 El desafío
Dos fases y una regla: persistencia real, nada simulado.
El Full Stack Challenge de Ensolvers planteaba una app de notas en dos etapas: la primera (obligatoria) cubría el CRUD completo de notas con archivar/desarchivar, y la segunda (opcional) agregaba categorías con filtrado por categoría.
Las condiciones de partida fijaban el estándar: persistencia relacional con ORM (prohibidas la memoria y los mocks como base de datos), un backend REST y un frontend SPA separados en carpetas, y un script que levantara todo el entorno con un solo comando.
02 Arquitectura y modelo de datos
Capas limpias y la relación muchos-a-muchos bien resuelta.
Organicé el backend en capas: controllers REST, servicios transaccionales, repositorios de Spring Data, DTOs para el contrato HTTP y un manejo de errores global y centralizado.
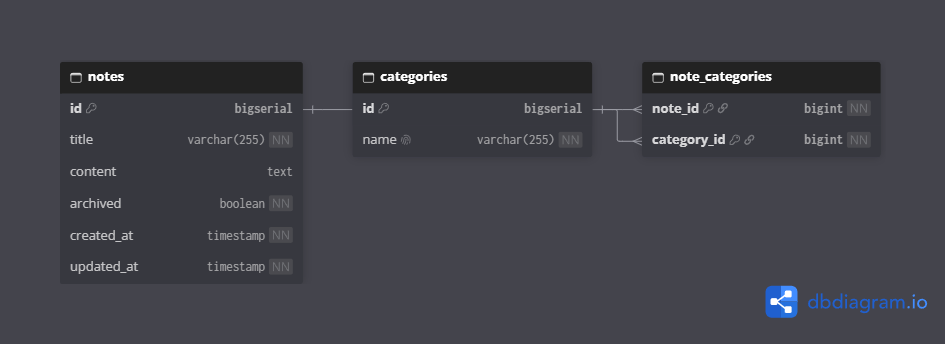
El modelo llega a dos entidades con una relación de muchos a muchos vía la tabla de join note_categories: una nota puede tener varias categorías y una categoría agrupa varias notas. Al borrar una categoría se desasocian primero las notas, para no dejar registros huérfanos.
PostgreSQL corre en Docker y el schema lo maneja Hibernate, con timestamps en Instant sobre UTC explícito para esquivar sorpresas de horario local.
03 API REST
Endpoints acotados, errores con nombre y apellido.
La API cubre el CRUD completo de notas (GET con filtros ?archived y ?categoryIds, POST, PUT, DELETE), el PATCH de archivar/desarchivar, y endpoints dedicados para asociar o quitar categorías sobre una nota.
La validación de servidor es con Bean Validation (título obligatorio y sin espacios), y el handler global de errores devuelve 404 si el recurso no existe, 409 cuando la categoría se duplica y 400 si una validación falla.
Las respuestas salen por DTOs con factories estáticas, manteniendo las entidades lejos del contrato HTTP.
04 Frontend
React sin peso de más: fetch nativo y estado local.
La SPA está hecha con React, Vite y TypeScript. Consumo la API con fetch nativo envuelto en un client propio que maneja errores, y el estado vive en useState del componente raíz, sin librerías de estado extra para esta escala.
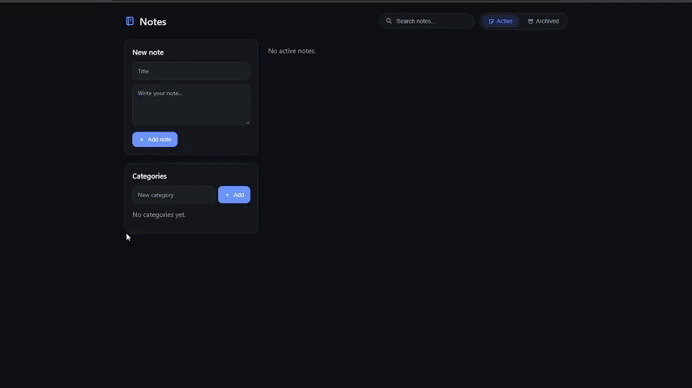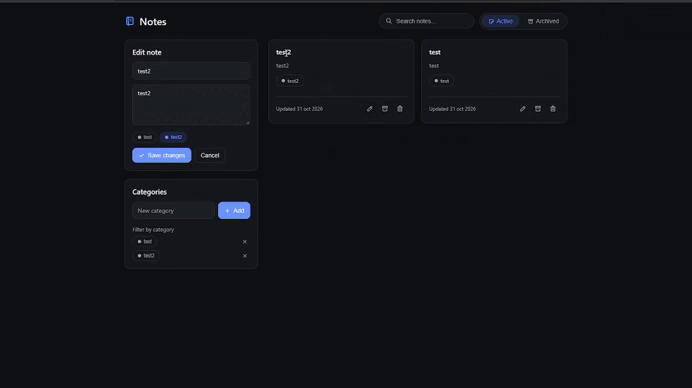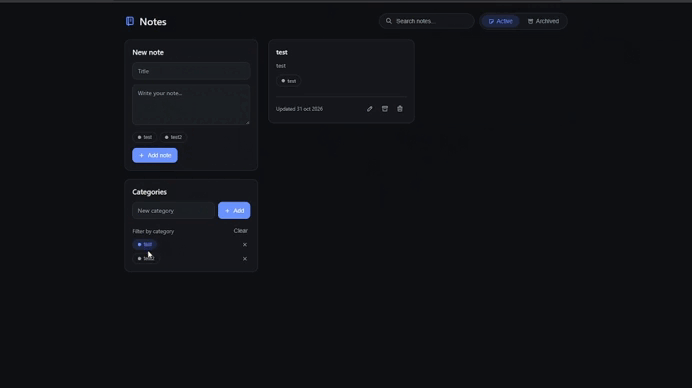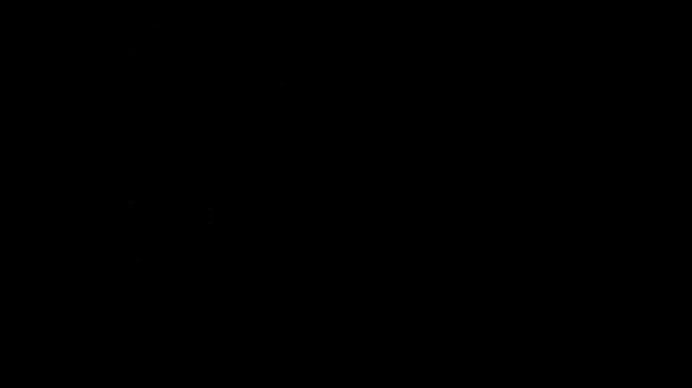
El flujo son pestañas Activas/Archivadas, pills de categorías que actúan como filtros de selección múltiple, búsqueda de texto y confirmaciones con SweetAlert2.
Hay criterio en lo que resuelve cada lado: el filtrado por categorías corre en el backend (JOIN con DISTINCT en la query), y la búsqueda de texto filtra en el frontend sobre títulos, contenido y nombres de categorías.
05 Testing
42 tests automatizados respaldando la lógica.
En el backend son 29 tests: unitarios de servicios con Mockito (CRUD completo, normalizaciones, archivado, categorías y conflictos) y cobertura de controllers con MockMvc, verificando los flujos HTTP reales (201, 204, 404 y errores de validación).
En el frontend son 13 tests con Vitest y Testing Library: carga inicial, búsqueda de texto, estados vacíos y comportamiento de las tarjetas de nota.
06 Developer experience
Todo arriba con un solo comando, en cualquier sistema.
El run.sh encadena el arranque completo en Mac/Linux: docker compose, espera del healthcheck de la base, Spring Boot hasta que la API responde con curl, y al final el frontend; al cerrar, baja todo con limpieza.
Para Windows preparé los .bat de arranque rápido: fijan los puertos (base :5433, backend :8090, frontend :5173) para no chocar contra servicios ya instalados, y terminan abriendo el navegador.
07 Lo que aprendí
Un ciclo completo: qué construir primero y qué delegar con criterio.
Reforcé Spring Boot 3 con Java 21, Spring Data JPA, el diseño de DTOs con records, la separación en capas y el manejo de errores HTTP, siempre pensando en un repo hecho para ser revisado por alguien más, no para consumirme yo solo.
También encontré los límites de delegar el schema a Hibernate (ddl-auto=update): es cómodo en desarrollo, pero en producción es exactamente donde aparecen preguntas de migraciones, tests de integración y documentación de la API.
08 Lo que haría ahora
El próximo paso es calidad de integración y migraciones.
Una suite de integración real con Testcontainers cubriría los repositorios contra PostgreSQL de verdad: la query JPQL de la relación muchos-a-muchos y los flujos de archivado de punta a punta.
Del otro lado, migraciones con Flyway para versionar el schema y Swagger/OpenAPI para documentar la API: las dos piezas que más distancia marcan entre un desafío técnico y un entregable listo para producción.
Stack tecnológico
Portada
Pantallas
Muchas Gracias por llegar hasta el final :D